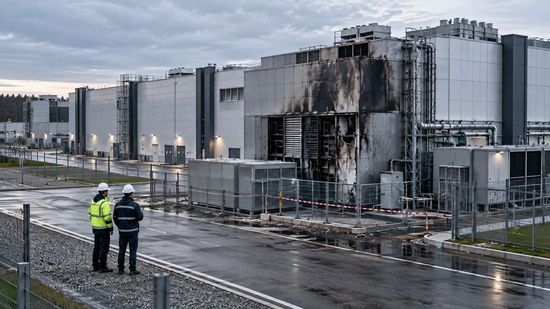
Октябрьские атаки на дата-центры — настоящая трагедия для технологической отрасли. За повреждёнными зданиями и серверами стоят годы инженерной работы, созданные продукты и люди, которые сейчас круглосуточно восстанавливают инфраструктуру. Для компаний, зависящих от этих площадок, последствия продолжаются после первых сообщений о сбоях: останавливаются бизнес-операции и процессы, срываются сделки, нарушаются сроки, поиск решений и альтернатив идет в режиме 24/7.
Мы в NeuroCore поддерживаем коллег, которые возвращают сервисы в работу. И считаем важным обсудить инженерную сторону происходящего: какие зависимости обнаруживает такая авария, что нужно для восстановления и где машинное зрение может помочь службе безопасности распознать угрозу.
Что известно на 15 октября
В ночь на 8 октября после атаки БПЛА полностью остановился дата-центр Яндекса в Сасово. Утром 9 октября атака затронула площадку в Калуге, часть инфраструктуры вышла из строя. В ночь на 11 октября был остановлен дата-центр во Владимире. Yandex Cloud сообщил об аварийном режиме и рекомендовал клиентам использовать альтернативные площадки для восстановления ресурсов. По сообщениям компании, сотрудники этих объектов не пострадали.
14 октября Сбер подтвердил атаку на свой ЦОД в Балакове. По заявлению первого зампреда правления Александра Ведяхина, сотрудники не пострадали, системы и сервисы банка продолжили работать штатно.
К 14 октября Yandex Cloud восстановил ряд ИИ-сервисов, включая основные API языковых моделей, Retrieval API и Embeddings API. При этом Workflows, Batch Inference API и Dedicated Models оставались недоступны, сохранялись ограничения на выделение новых ресурсов. Возвращение части функций ещё не означает полного восстановления инфраструктуры.
Последствия выходят за пределы первого сбоя
В первые часы бизнес замечает недоступный сайт, ошибки приложения или остановку обмена данными. Затем начинаются задачи, которые требуют гораздо больше времени: восстановить окружение, проверить целостность информации, вернуть интеграции и обработать накопившиеся операции.
Первый риск — разрыв между техническим запуском и возвращением рабочего процесса. Страница уже открывается, но часть функций может оставаться недоступной. Для компании это означает необходимость проверять весь путь: от поступления заявки до её обработки и передачи результата клиенту.
Второй риск связан с доступностью мощностей. После крупной аварии многим клиентам одновременно нужны серверы и хранилища. Возможность восстановиться зависит от того, где и на каких ресурсах запускать приложения. Экстренный поиск площадки становится частью простоя.
Третий риск — внешние зависимости. Компания может не размещать основную систему в пострадавшем облаке, но использовать его API для распознавания документов, обработки речи или работы ИИ-ассистента. Недоступность отдельного компонента способна остановить отдельную функцию в исправно работающем приложении.
Для ИИ-проектов это чувствительно. Ассистент может зависеть от языковой модели, хранилища документов, поиска по базе знаний и сервиса авторизации. Резервирование только одного компонента не обеспечивает работу всей системы. При проектировании нужно определять минимальный набор функций, который должен сохраниться при отказе внешних сервисов.
Есть и отложенная организационная цена. Команды переключаются на восстановление, согласование переезда и поддержку пользователей. В таких условиях разработка новых функций и внедрение автоматизации могут отойти на второй план. Размер этих потерь зависит от бизнеса; универсальной суммы ущерба здесь нет.
Почему сохранённой копии может оказаться недостаточно
Наличие резервной копии ещё не определяет, как быстро компания возобновит работу после потери дата-центра. Для запуска системы нужны вычислительные ресурсы, совместимое окружение, сетевые настройки и доступные сервисы, от которых зависит приложение. Если эти условия не подготовлены заранее, восстановление превращается в экстренную инженерную работу с неопределённым сроком завершения.
Как инфраструктурные зависимости задерживают восстановление
Конкретный пример описал системный администратор AGIMA Павел Ковальчук в разборе восстановления портала после октябрьской аварии Yandex Cloud. Рабочая система, DNS, средства защиты веб-трафика и 14 резервных копий находились в инфраструктуре одного провайдера.
После первых инцидентов команда подготовила внешнюю копию системы. Проверка выявила проблему переносимости: сетевые настройки виртуальной машины зависели от механизмов исходного облака. Для запуска в инфраструктуре AGIMA их пришлось исправлять вручную.
Когда основная площадка остановилась, обнаружились дополнительные препятствия. Вместе с приложением стали недоступны компоненты фильтрации трафика, а управление DNS временно не работало. Даже готовая внешняя копия не позволяла немедленно переключить пользователей.
Временное восстановление выполнили из уцелевшего снимка внутри Yandex Cloud: портал запустили на двух процессорных ядрах вместо штатных восьми. Для фильтрации трафика развернули отдельный прокси-сервер в Selectel. После возвращения доступа к DNS команда переключила записи и восстановила доступность портала. Позднее систему полностью перенесли в Selectel с синхронизацией данных.
Этот случай показывает, почему проверка восстановления должна охватывать весь путь пользователя до приложения. Работоспособность виртуальной машины — только один из этапов. Необходимо также обеспечить разрешение доменного имени, защищённое подключение и доступность зависимых компонентов.
Что должно быть подготовлено помимо бэкапа
В материале «Хайстекс» об аварийном восстановлении после потери ЦОДа отдельно рассматриваются резервное копирование и Disaster Recovery — организация восстановления инфраструктуры после аварии.
Резервная копия позволяет вернуть данные к определённому состоянию. Для восстановления сервиса на другой площадке дополнительно требуются вычислительные мощности, хранилища, сеть и порядок запуска компонентов. Степень готовности резервной инфраструктуры выбирают исходя из допустимого простоя.
Распределение системы по нескольким зонам доступности также имеет границы применимости. Нужно учитывать общие сервисы управления, квоты, географию размещения и способность приложения продолжать работу при отказе части инфраструктуры. При масштабной аварии создание новых ресурсов в уцелевших зонах может быть ограничено.
Поэтому сценарий потери основной площадки целиком следует проверять отдельно: где будут доступны данные, какие мощности можно использовать и какие зависимости сохранятся у резервной системы.
Как определить требования к восстановлению
Планирование начинается с двух измеримых параметров, которые описаны, в частности, в AWS Well-Architected Framework:
- RTO — целевое время восстановления. Максимально допустимый период от остановки сервиса до возобновления его работы.
- RPO — допустимая потеря данных, выраженная во времени. Определяет, насколько далеко от момента аварии может находиться последняя пригодная точка восстановления.
Эти требования устанавливают для конкретных систем с учётом последствий для бизнеса и возможностей зависимых сервисов. Например, восстановление приложения за час не решит задачу, если необходимый ему сервис авторизации будет недоступен значительно дольше.
Как проверить готовность плана
Готовность к аварии подтверждается успешным восстановлением в заданные сроки. В рекомендациях AWS по тестированию Disaster Recovery предусмотрены регулярные проверки переключения на резервную площадку и достижения установленных RTO и RPO.
Во время таких испытаний необходимо проверить запуск компонентов по рабочей инструкции, доступность приложения и способность резервной инфраструктуры выдержать требуемую нагрузку. Выявленные проблемы должны попадать в план исправлений: со временем меняются объём данных, конфигурация и требования к ресурсам. Успешное испытание годичной давности не подтверждает готовность текущей системы.
Для руководителя результат такой проверки должен выражаться конкретно: какой процесс восстановлен, за какое время, на какую дату актуальны данные и с какими ограничениями компания сможет продолжать работу.
Облако NeuroCore — инфраструктура для наших клиентов
У нас в NeuroCore есть собственное облако, которое мы собрали для клиентских проектов. Это закрытая инфраструктура: мы не предлагаем её на публичном рынке как отдельный облачный сервис. Она входит в техническую базу, которую наша команда использует при работе с заказчиками.
О создании облака мы ранее рассказывали в нашем Telegram-канале. Тогда речь шла о развитии инфраструктуры под определенные задачи. На фоне октябрьских событий у этой работы появилась дополнительная ценность: собственное облако нас выручило и стало дополнительной опорой в работе с клиентскими проектами.
Для разработчика AI-систем инфраструктура — важная часть решения. Моделям нужны вычислительные ресурсы, приложениям — среда выполнения, данным — хранение и обработка. От доступности этих компонентов зависит возможность пользоваться продуктом. Поэтому ответственность технической команды распространяется и на условия, в которых созданная система будет работать.
Наличие собственного облака расширяет наши возможности при выборе архитектуры. В зависимости от задачи заказчика мы можем рассматривать локальное развёртывание, собственную облачную инфраструктуру или сочетание нескольких сред. Такой выбор требует учитывать требования к данным, нагрузке, интеграциям и доступности системы.
Октябрьские события подтвердили практическую ценность уже сделанной работы. Инфраструктура, которую мы создавали для клиентов, оказалась полезна в сложной ситуации. Для нас это весомый аргумент продолжать вкладываться в техническую базу NeuroCore и учитывать инфраструктурные зависимости с самого начала каждого проекта.
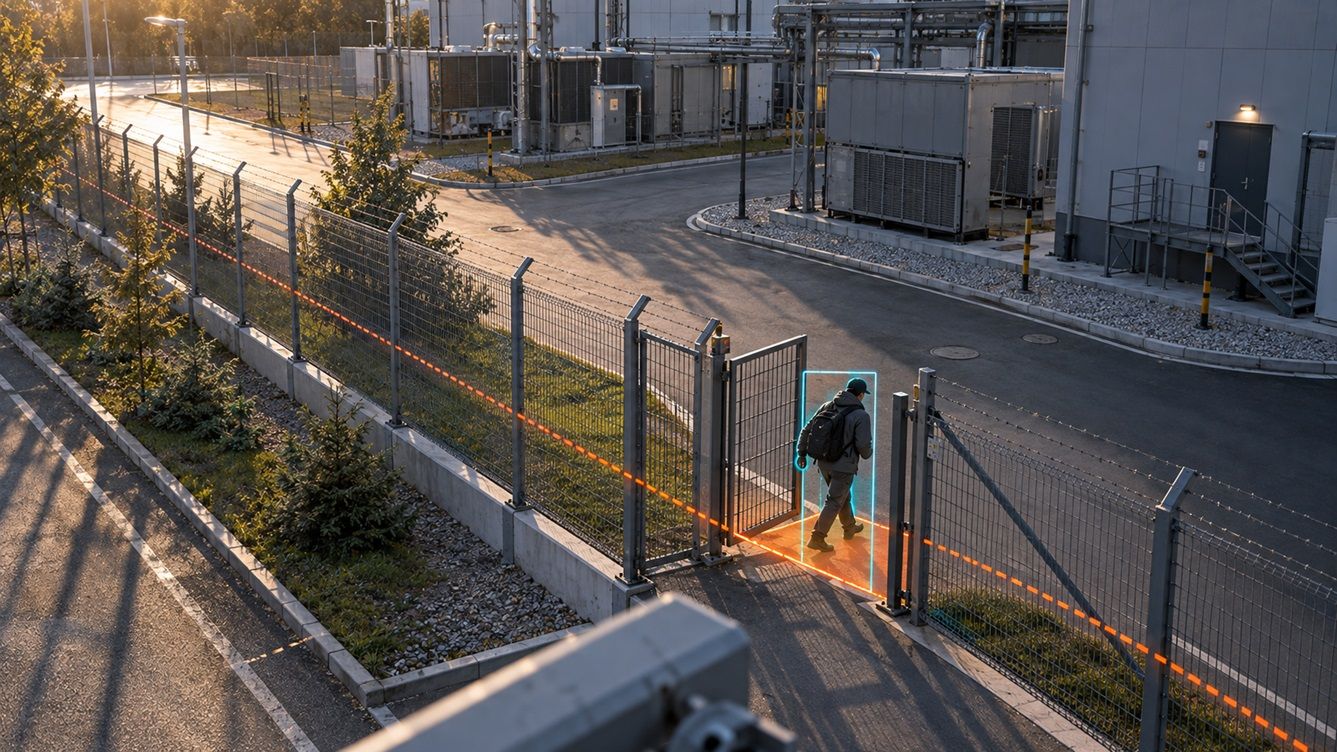
Сценарии применения машинного зрения для защиты объектов
Резервная инфраструктура позволяет восстанавливать сервисы после аварии. На самой площадке необходимы средства обнаружения угроз и организация реакции. Машинное зрение помогает выявлять наблюдаемые признаки происшествия и передавать службе безопасности событие с подтверждающими материалами.
Сценарии определяются устройством объекта, доступными камерами и оборудованием. Для промышленной площадки или дата-центра можно выделить несколько направлений
| Сценарий | Что анализирует система | Как результат используется службой безопасности |
| Пересечение периметра | Пересечение запрещённой линии, преодоление ограждения, длительное нахождение в контролируемой зоне, передача или переброс предметов через забор | Оператор получает место события и видеофрагмент, позволяющий проверить происходящее и направить сотрудников |
| Несанкционированный проход | При сопоставлении видео с событиями СКУД — фактическое количество прошедших людей и выданные разрешения. Например, проход нескольких человек по одной авторизации | Служба безопасности может проверить конкретный эпизод и установить обстоятельства нарушения режима доступа |
| Видимые признаки угрозы людям | Различимые в кадре предметы, похожие на оружие, возможная драка, падение человека или резкое групповое изменение движения | Система выделяет эпизод для приоритетной проверки. Окончательную оценку ситуации выполняет оператор |
| Подозрительные предметы при досмотре | Изображения интроскопа: признаки согласованных категорий запрещённых предметов и области, требующие дополнительной проверки | Оператор досмотра получает визуальную подсказку. Этот сценарий требует отдельного подключения к досмотровому оборудованию |
| Дым и открытый огонь | Видимые признаки задымления и пламени в заданных зонах, их появление и развитие во времени | Ответственные сотрудники получают сигнал с изображением участка и могут действовать по регламенту объекта |
| Въезд и перемещение транспорта | Номерной знак, направление движения, пересечение контрольной линии, время въезда и выезда | Формируется журнал событий, который помогает проверять движение транспорта и разбирать спорные эпизоды |
Обнаружение БПЛА требует отдельного технического решения. Для него необходимо оценивать обзор воздушного пространства, характеристики камер, различимость цели и возможность её сопровождения. В зависимости от задачи видеонаблюдение дополняют специализированными датчиками. Возможности наземной охраны периметра сами по себе не подтверждают способность системы обнаруживать воздушные угрозы.
Как превратить обнаружение в своевременную реакцию
Для каждого сценария нужно заранее определить условия срабатывания: контролируемую зону, направление движения, длительность события и допустимые исключения. Например, появление человека рядом с ограждением ещё не означает проникновения. Система должна учитывать наблюдаемое действие и согласованные правила объекта.
Результатом обработки становится карточка события: тип, место, время, источник сигнала, ключевые кадры или короткий видеофрагмент. Продолжающийся эпизод должен обновляться в одной карточке, чтобы оператор не получал множество одинаковых тревог.
Отдельно необходимо контролировать доступность источников. Потеря видеопотока или недостаточная видимость должны отображаться как невозможность проверки: в такой ситуации система не может подтвердить, что участок находится в штатном состоянии.
Далее включается регламент службы безопасности: кто проверяет уведомление, кому передаёт информацию и какие действия выполняет. Эффективность решения оценивается по всей последовательности — от наблюдаемого события до реакции ответственных сотрудников.
Такой подход мы используем в NeuroCore
В проекте AI-видеоаналитики для охраны производственных объектов мы сформировали архитектуру аналитического слоя поверх существующей системы видеонаблюдения. Предусмотрены получение потоков напрямую с камер или через VMS и передача оператору классифицированных событий с подтверждающими материалами.
Особое внимание уделено ложным срабатываниям: перед масштабированием необходимы сбор данных конкретной площадки, калибровка и проверка моделей в реальных условиях. Обнаружение БПЛА выделено в отдельную исследовательскую проработку.
Предпроектный этап завершён: определены архитектура, требования к данным, сценарии интеграции и план пилотирования. Следующая задача — проверить выбранные сценарии на ограниченном числе зон и подтвердить качество, достаточное для работы службы безопасности.
Обсудите применение ИИ для безопасности ваших объектов
Какие угрозы можно выявлять с помощью существующих камер? Где потребуется дополнительное оборудование? Как встроить видеоаналитику в работу службы безопасности?
Получите консультацию команды NeuroCore: разберём задачи вашего объекта, предложим сценарии применения ИИ и первый этап, на котором можно проверить их эффективность в реальных условиях: