Подключить внешний ИИ-сервис можно за день: регистрация ---> отправили запрос -----> получили ответ и пользуетесь.
А что быть, если за рабочими запросами компании стоит договор под NDA, медицинская карта, видеопоток с проходной объекта критической инфраструктуры или карточка клиента с персональными данными? Служба ИБ не согласует модель, которая тянет данные из CRM, ERP и базы знаний через публичный контур. Документы нельзя выгружать наружу. Видео должно оставаться на объекте. Для значимого объекта КИИ иностранный сервис —нарушение.
В закрытой инфраструктуре ИИ-решения собирают иначе. Здесь не сработает простой путь: выбрать модель и написать промпт. Нужно решить, где стоят серверы, какие данные попадают в модель, кто видит ответы, что пишется в журнал, как система обновляется и кто отвечает за её работу через полгода после пилота.
В 2025–2026 годах важность контроля над данными опережает скорость внедрения
Российские компании смотрят на ИИ не только как на способ "ускорить" сотрудников. Встают вопросы технологической независимости, контроля над данными, совместимости с инфраструктурой, импортозамещения и сопровождения без привязки к внешнему поставщику.
Для госсектора и объектов КИИ эта логика жёстче. Иностранное ПО на значимом объекте проходит отдельную проверку. В промышленных, транспортных, энергетических, финансовых и медицинских организациях то же самое: данные чувствительные, а процессы дорогие.
Поменялись и сами ИИ-системы. Раньше модель отвечала на вопрос и на этом останавливалась. Сейчас агент подключается к документам, заявкам, CRM, ERP, базам знаний, почте и видеопотокам, вызывает инструменты, меняет статус задачи, готовит решение для сотрудника. Он получает доступ к данным и совершает действия.
В связи с этим, вопрос "где работает модель" стал таким же весомым, как "насколько точно и качественно модель отвечает".
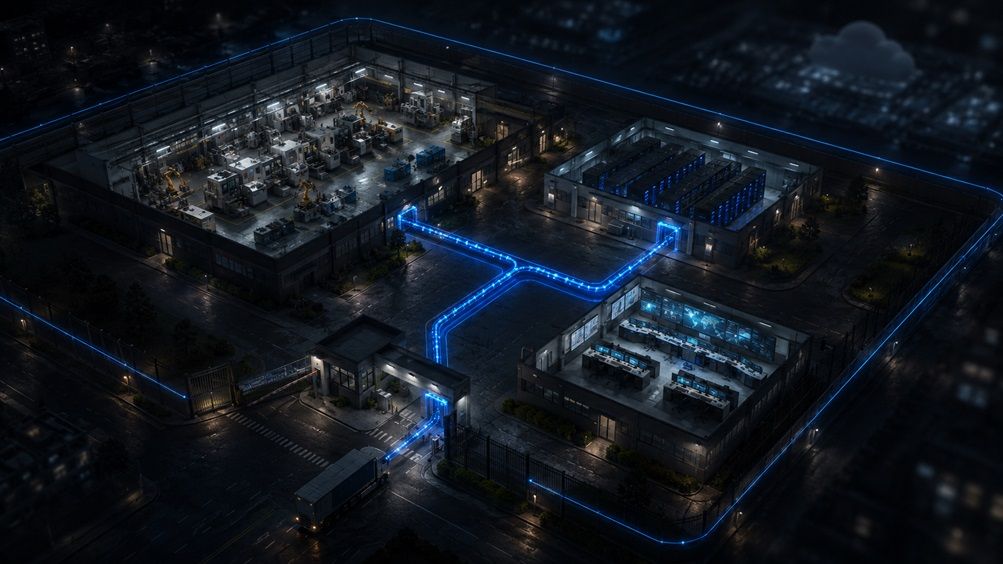
Формы закрытой инфраструктуры: от on-prem до гибрида
Закрытая инфраструктура — не обязательно серверная без интернета за железной дверью. Она принимает разные формы.
Модель работает на серверах заказчика
Разворачивается в частном облаке (private cloud).
Живёт в выделенном контуре дата-центра.
Считает на локальном GPU-сервере прямо на объекте.
Работает в гибридной схеме: чувствительные данные остаются внутри, наружу уходит обезличенный или урезанный запрос.
Форма разная, суть одна: компания сохраняет контроль над данными и доступом. Для этого она должна понимать:
- где физически находятся данные;
- кто имеет к ним доступ;
- какие системы подключены к модели;
- что из данных уходит наружу и что остаётся внутри;
- как логируются запросы и ответы;
- чем ограничены действия агента;
- кто обновляет модель, индексы, API и интеграции;
- что происходит при сбое.
Закрытый контур появляется там, где данные и ответственность нельзя вынести в публичный сервис без отдельного анализа рисков. За ним стоит цена ошибки.
Локальное развёртывание нужно не под каждую задачу
Здесь легко впасть в крайность: раз есть риски — ставим всё on-prem. Это тоже ошибка.
Локальное развёртывание дороже и сложнее в эксплуатации. Нужны серверы, GPU или CPU, хранилище, резервное копирование, мониторинг, обновления, администрирование и люди, которые знают, что делать при падении качества.
Задачи распадаются на четыре класса.
- Для черновиков, открытых данных, прототипов, генерации идей и маркетинговых материалов без чувствительной информации хватает внешнего API
- Для данных, которые нельзя отдавать целиком, подходит гибрид. Чувствительная часть остаётся внутри, наружу уходит очищенный фрагмент: без персональных данных, коммерческой тайны и прямого доступа к системам
- Корпоративные документы, закрытые базы знаний, видеопотоки с объектов, персональные, медицинские и финансовые данные, КИИ, процессы с высокой ценой ошибки — здесь работает on-prem или private cloud.
- Четвёртый вариант — не внедрять генеративный ИИ вообще. Иногда задачу закрывает OCR, классификатор, обычный поиск, набор правил, backend-сервис с очередью и журналом. Большая языковая модель тут добавит стоимость и непредсказуемость, а выигрыша не даст.
Зрелая архитектура начинается не с вопроса "какую модель поставить", а с вопроса "какой способ обработки допустим для этих данных и этого процесса".
Семь слоёв ИИ-системы внутри компании
Когда ИИ работает в закрытом контуре, модель — одно звено. Вокруг неё выстраивается система из семи слоёв.
- Данные. Документы, заявки, изображения, видеопотоки, таблицы, регламенты, логи, карточки клиентов, производственные события, записи диалогов, справочники, архивы. На этом этапе решают, какие данные нужны модели, где они лежат, в каком они качестве и кто вправе их использовать.
- Хранилище. Документам нужны файловое хранилище и векторная база. Видеоаналитике — архив событий, кадры, фрагменты, метаданные. OCR — оригиналы файлов, распознанные поля, статусы проверки. Агенту — история задач, действия, источники, результаты.
- Модельный контур. LLM, CV-модель, OCR, embedding-модель, speech-to-text, классификатор, сегментация, трекинг или связка из нескольких. В закрытом контуре отдельно проверяют, что запускается локально, что требует внешнего API, что даёт приемлемое качество на русском языке и что вписывается в имеющееся оборудование.
- Бизнес-логика. Модель предложила ответ, распознала поле, нашла объект. Дальше система решает, что с этим делать: отправить на проверку, записать событие, вернуть JSON, поднять алерт, создать задачу, обновить статус, заблокировать действие до подтверждения человеком.
- API и интеграции. ИИ редко работает сам по себе. Он берёт данные из CRM, ERP, WMS, VMS, SCADA, документооборота, базы знаний, телефонии, почты. Потом возвращает результат туда же — с идентификатором, статусом, временем, ссылкой на источник и причиной решения.
- Интерфейс. Чат-ассистент, кабинет сотрудника, АРМ оператора, панель администратора, журнал событий, экран разметки спорных случаев. Через интерфейс человек видит, что система сделала, почему так решила и где проверить источник.
- Мониторинг и сопровождение. Логи, метрики, ошибки, latency, нагрузка, качество ответов, версии моделей и промптов, индекс базы знаний, статусы интеграций, инциденты, обновления. Без этого слоя система превращается в "чёрный ящик".
ИИ в закрытом контуре складывается из данных, моделей, API, прав, журналов, интерфейса и эксплуатации. Модель отвечает за одно звено из семи.
Наличие серверов не означает готовности к запуску
Свои серверы у компании, зачастую, уже есть. Это ещё не значит, что внедрение ИИ будет происходить на них.
Нагрузка зависит от задачи. Небольшому RAG-ассистенту по документам хватит одной архитектуры. Локальной LLM на десятки пользователей — другой. Видеоаналитике с потоками с камер — третьей. Пакетному OCR на тысячи файлов — четвёртой.
Считать приходится отдельно:
- сколько пользователей работает одновременно;
- сколько запросов в час ожидается;
- какой размер документов;
- сколько камер и видеопотоков;
- нужна ли обработка в реальном времени;
- какая задержка допустима;
- где хранить исходники и результаты;
- сколько держать архив;
- нужен ли GPU;
- система только запускает модель или ещё дообучает её;
- как обновлять модели и зависимости без остановки процесса.
Локальная LLM упирается в память GPU. Видеоаналитика — в FPS, разрешение и число потоков. OCR — в очередь документов и скорость обработки. RAG — в качество индекса, хранение фрагментов, обновление базы и контроль источников. Агент — в безопасность инструментов, которые ему разрешено вызывать.
Есть и второй неприятный момент: железо стареет быстрее, чем растут ожидания от ИИ. Модель, которая сегодня выглядит приемлемо, через год проигрывает новым версиям по качеству и скорости. Поэтому on-prem планируют внутри жизненного цикла системы: сервер под ИИ придётся обновлять вместе с моделями.
Модель работает, а процесс не меняется
Сотрудник открывает отдельный интерфейс, копирует туда текст, получает ответ, потом руками переносит результат в CRM, Excel, документооборот или письмо. Испытывает неудобство. Через неделю люди возвращаются к старому процессу: новый добавил ещё одно окно и лишние движения.
Рабочий ИИ встроен в процесс. CRM отдаёт обращение клиента — ассистент классифицирует тему, достаёт контекст из базы знаний, предлагает ответ и возвращает его в карточку. ERP отдаёт документ — OCR и LLM извлекают поля, сверяют расхождения, выставляют статус проверки. VMS отдаёт видеопоток — CV-модель фиксирует событие, API передаёт алерт, журнал сохраняет кадр. Сотрудник спрашивает по регламенту — RAG отвечает со ссылками на конкретные документы, а не выдаёт мнение модели.
API решает три задачи. Система получает данные без ручного копирования. Результат возвращается туда, где с ним работают. Каждое действие остаётся проверяемым: запрос, источник, версия модели, ответ, статус, пользователь, время, ошибка, подтверждение.
Безопасность — до первой строки кода
Закрытый контур не делает ИИ безопасным сам по себе. Он снижает часть рисков: данные не уходят во внешний сервис, модель работает ближе к источнику, доступ проще контролировать. Но если внутри всё открыто всем, локальный запуск не спасает.
- Сначала — данные. Что можно отдавать модели, а что нельзя. Нужно ли обезличивание. Можно ли сохранять запросы и ответы. Что попадёт в лог и что нужно удалять. Какие документы не индексируются. Какие поля скрыты от пользователей с определённой ролью.
- Потом доступы. Ассистент не должен видеть больше, чем видит сотрудник. Если менеджеру закрыты финансовые документы, ассистент для менеджера тоже их не достаёт. Если оператор работает с одним объектом, его интерфейс не показывает события по всей сети. Для этого нужны роли, группы, сервисные учётные записи, принцип минимальных привилегий и отдельный контроль действий агента.
- Сеть. Где стоит сервер, какие порты открыты, есть ли прямой выход наружу, через какой шлюз система ходит к внутренним API, что произойдёт при компрометации одного сервиса.
- Отдельный слой — логи. В ИИ-проекте хочется логировать всё: промпты, ответы, документы, ошибки, действия пользователя. Но лог сам становится утечкой. Если в нём остаются персональные данные, коммерческая тайна, фрагменты договоров или медицинская информация, его защищают не слабее исходной системы.
- Специфические AI-риски. Например, prompt injection. Агент читает документ, письмо или страницу и получает оттуда вредную инструкцию, хотя пользователь ничего подобного не вводил. Для человека это мусор, для модели — потенциальная команда. Поэтому агенту не дают свободный доступ ко всем инструментам: нужен "белый лист" действий, подтверждение критичных операций, проверка источников, фильтры, ограничения на запись. Модель предлагает. Человек подтверждает там, где ошибка дорогая.
Персональные данные, КИИ и импортозамещение в РФ
Если в задаче есть персональные данные, обязательно определяют оператора и обработчика, основание обработки, возможность поручить обработку подрядчику, перечень действий с данными, место хранения, состав логов и меры защиты. Для ИИ это чувствительно вдвойне: модель получает фрагменты документов, переписку, записи звонков, изображения, лица, голоса, клиентские карточки, HR-данные.
Если данные уходят во внешний API, появляется вопрос трансграничной передачи и локализации. Даже когда сервис "просто обрабатывает текст", в него уходит содержимое документа, обращения, медицинской записи, договора или регламента. Для закрытых процессов поэтому берут локальную модель, private cloud или гибрид с фильтрацией данных.
Если объект относится к КИИ, критической информационной инфраструктуре, разговор строже. Учитывают категорирование, требования по защите, журналы, инциденты, взаимодействие с инфраструктурой безопасности, ограничения на иностранное ПО, требования к поставщикам и сопровождению. ИИ здесь не ставят отдельным сервисом — он вписывается в контур безопасности объекта.
Импортозамещение меняет постановку задачи. Речь не только про замену одного продукта другим. Для ИИ-проекта важна совместимость с российскими ОС, базами, средствами виртуализации, инфраструктурой заказчика и внутренними регламентами. Иногда это означает on-prem, иногда — российские компоненты, иногда — гибрид, где критичный контур остаётся локальным.
RAG в закрытом контуре: загрузить документы недостаточно
Многие корпоративные ИИ-проекты стартуют с идеи: загрузим регламенты, инструкции, договоры, базу знаний — и сотрудники будут задавать вопросы.
Технически это RAG. Документы режут на фрагменты, индексируют, по запросу система ищет релевантные куски и передаёт их модели. Закрытому контуру схема подходит: документы остаются внутри, модель отвечает по корпоративным источникам, сотрудник получает ссылку на документ.
Сам по себе RAG тоже не работает. Нужно решить, какие документы вообще индексировать, кто отвечает за их актуальность, как удаляются устаревшие версии, что делать с противоречиями в регламентах, как система показывает источник и как ограничиваются права: сотрудник не должен получить ответ на основе документа, к которому у него нет доступа.
Отдельная проблема — фрагментация. Плохо порезанный документ отдаёт модели кусок без контекста. Старые версии в индексе дают устаревший ответ. Сканы без нормального OCR ломают поиск. Документы без структуры и на разных языках заставляют ассистента отвечать уверенно и неточно.
В рабочей RAG-системе база знаний — управляемая история: источники, версии, права, индексация, обновления, ссылки, журнал вопросов и оценка качества ответов.

AI-агенты: доступы важнее автономности
Ассистент отвечает на вопрос. Агент выполняет шаги: находит документ, проверяет статус заявки, вызывает API, готовит письмо, создаёт задачу, обновляет поле, отправляет уведомление. Чем больше действий разрешено, тем строже архитектура.
У агента должны быть границы:
- какие системы он видит;
- какие действия выполняет сам;
- какие требуют подтверждения;
- какие данные нельзя использовать в ответе;
- какие операции запрещены полностью;
- как фиксировать каждый шаг.
Агент готовит проект ответа клиенту, но не отправляет его без менеджера. Находит расхождение в документе, но не меняет статус договора без юриста. Предлагает категорию заявки, но не закрывает обращение без оператора. Подсказывает вероятный дефект на видео, но не останавливает линию без заданного правила или сигнала от системы управления.
Автономность без ограничений выглядит красиво в презентации. В реальном внедрении ценнее понятные права, проверяемые действия и возможность быстро остановить агентский сценарий, если он повёл себя неправильно.
Без сопровождения система тихо деградирует
В облачном сервисе часть проблем скрыта от клиента: провайдер обновляет модель, масштабирует инфраструктуру, чинит внутренние сбои. В закрытом контуре эта ответственность переезжает внутрь проекта.
Модель нужно обновлять. Индексы RAG — пересобирать. Документы меняются. Внутренние API меняются.
Пользователи задают новые вопросы. Появляются новые типы файлов. Камеры меняют ракурс. OCR встречает новый шаблон.
Классификатор начинает ошибаться на новых данных. Сотрудники обходят процесс, и агент перестаёт получать нужный контекст.
Без сопровождения спустя месяцы система начинает "сдавать". Контур эксплуатации закрывает эту деградацию: мониторинг доступности, контроль задержек и качества ответов, журнал ошибок, версии моделей и промптов, регламент обновления базы знаний, обработка инцидентов, разбор ложных срабатываний, дообучение и настройка, проверка интеграций, резервное копирование, план восстановления после сбоя.
Проект не заканчивается запуском. В закрытом контуре система становится частью IT-ландшафта компании, и сопровождают её как рабочую систему.
Семь ошибок, которые повторяются из проекта в проект
- Начинать с модели. Команда выбирает LLM, CV-модель или OCR, а потом ищет, куда её прикрутить. Идти надо от процесса: где теряется время, где ошибка дорогая, какие данные доступны, кто принимает решение, куда попадает результат.
- Считать on-prem автоматической гарантией безопасности. Данные не ушли наружу, но внутри модель получила широкие права, логи хранят чувствительные данные, доступы не разделены, админский интерфейс открыт слишком многим.
- Не считать расходы на эксплуатацию. Сервер купили, пилот запустили. Через три месяца нужно обновить модель, пересобрать индекс, почистить очередь, починить интеграцию, разобрать ошибки, а ответственного нет.
- Давать агенту слишком много свободы. Агент читает, пишет, отправляет и меняет статусы без ограничений — и превращается из помощника в новый источник риска.
- Не вести журнал. В ИИ-системе сохраняют и результат, и путь к нему: какой был запрос, какие источники использованы, какая версия модели работала, что вернул API, кто подтвердил действие.
- Менять весь процесс сразу. Лучше взять один участок: входящие заявки, поиск по базе знаний, разбор документов, классификацию обращений, контроль видео — довести до эксплуатации, собрать метрики и расширять.
- Не подключать ИБ, владельцев систем и будущих пользователей на этапе архитектуры. Тогда пилот получается красивым, но не проходит согласование, потому что нарушает реальные правила компании.
Правильно внедрённый ИИ в закрытом контуре дает управляемость.
Данные остаются под контролем компании. Сотрудники работают с ассистентом внутри привычного процесса. ИБ понимает, какие системы подключены и какие действия разрешены. Руководитель видит журнал и метрики. Техническая команда знает, где крутится модель, как она обновляется и что делать при сбое. Пользователь получает ответ с источниками, статусом и возможностью проверить.
ИИ приносит пользу тогда, когда его ответ можно безопасно встроить в решение.
Обсудить проект
Мы в NeuroCore разрабатываем нейросети и ИИ-системы с 2017 года, у нас есть опыт работы с чувствительными данными, объектами критической инфраструктуры и режимными объектами.
Готовы разобрать ваши процессы и ограничения, подобрать сценарии работы и архитектуру, оставьте заявку на сайте, это бесплатно: