На корпоративном рынке существует устойчивая иллюзия, что внедрение машинного обучения — это разовая ИТ-закупка. Бизнес привык к парадигме классического программного обеспечения: купили лицензию, подрядчик настроил интеграцию с внутренней инфраструктурой, система перешла в стадию поддержки.
На практике разработка ИИ решений — это запуск непрерывного инженерного процесса, который требует совершенно иного подхода к эксплуатации и SLA.
Сложности начинаются в момент, когда компании требуется кастомная разработка ИИ для бизнеса, но в договоре и процессах она описывается терминами классической системной интеграции. В результате возникают конфликты: алгоритм начинает выдавать ошибки, заказчик требует исправить «баги» по гарантии, а разработчик указывает на то, что изменились физические условия на объекте.
В этой статье мы разберем, где заканчивается работа классического ИТ-интегратора и начинается инжиниринг данных, как разделить зоны ответственности на проекте и почему поддержка ML-систем требует развертывания полноценных MLOps-конвейеров.
Уровни погружения: интеграция, разработка и гибридный подход
Чтобы понять границы ответственности, необходимо разделить три совершенно разных подхода к внедрению ИИ в бизнес-процессы.
1. Чистая ИИ-интеграция (Транспортный уровень)
В этом сценарии используются готовые решения (Off-the-shelf) или облачные API от крупных вендоров. Задача интегратора сводится к обеспечению инфраструктурной связности. Инженеры настраивают маршрутизацию запросов, пишут вебхуки, поднимают брокеры сообщений (например, Kafka или RabbitMQ) и настраивают коннекторы к ERP, WMS, CRM или системам видеонаблюдения заказчика. Интегратор здесь не контролирует саму нейросеть — она остается «черным ящиком». Его зона ответственности — убедиться, что данные из точки А (например, с IP-камеры) стабильно уходят на сторонний сервер, а ответ в виде JSON-файла без задержек ложится в базу данных компании. Главные метрики на этом этапе: пропускная способность сети, отказоустойчивость коннекторов и корректная обработка таймаутов.
2. Глубокая ML-разработка (Когнитивный уровень)
Разработка начинается там, где готовые API не справляются с физикой реального мира: сложная геометрия промышленных цехов, нестандартные SKU на складе, высокая плотность потока или жесткие требования к безопасности, исключающие облачные вычисления. Здесь фокус смещается на работу с данными и архитектурой моделей.
Команда собирает сырые данные (видео, логи, телеметрию), формирует манифесты датасетов, проводит разметку, обучает веса и оптимизирует вычислительные графы. Отдельный пласт работы — сайзинг оборудования. Чтобы тяжелая модель компьютерного зрения или локальная VLM (Vision-Language Model) работала on-premise, разработчику необходимо сбалансировать размер модели с объемом VRAM доступных серверов, добиваясь нужной скорости инференса.
3. Профильный ИИ интегратор (Full-stack инжиниринг)
На практике промышленным заказчикам редко нужна чистая наука (Jupyter-ноутбук с весами модели) или чистая интеграция (коннектор без понимания сути данных). Рынок требует комплексного подхода. ИИ интегратор забирает на себя обе функции: он разрабатывает кастомную ML-модель под уникальный процесс, упаковывает ее в микросервис и бесшовно встраивает в сложную IT-инфраструктуру предприятия, учитывая все ограничения службы безопасности и аппаратного обеспечения.
Границы ответственности: где заканчивается магия и начинается SLA
Разделение ролей напрямую влияет на то, как формулируются гарантийные обязательства. В классическом ПО баг — это ошибка в коде. В машинном обучении алгоритм может работать математически безупречно, но выдавать неверный бизнес-результат. Поэтому на проектах с внедрением ИИ критически важно разделять SLA на две независимые части.
Инфраструктурный SLA (IT-метрики)
Это зона классической технической поддержки. Она включает в себя:
- Аптайм (доступность) серверов и Docker-контейнеров с моделями.
- Стабильность входящего видеопотока (отсутствие потери кадров при передаче от VMS-системы).
- Загрузку GPU и контроль утечек памяти (Memory Leaks).
- Скорость ответа системы (Latency) при штатной нагрузке. За сбои на этом уровне подрядчик несет прямую техническую ответственность, и они закрываются стандартным багфиксом.
Алгоритмический SLA (ML-метрики)
Качество распознавания (Precision, Recall, mAP, F1-score) фиксируется только для конкретного набора условий и валидационного датасета. Модель обязана выдавать заявленные 95-98% точности на тех данных, на которых она была обучена и протестирована при сдаче этапа.
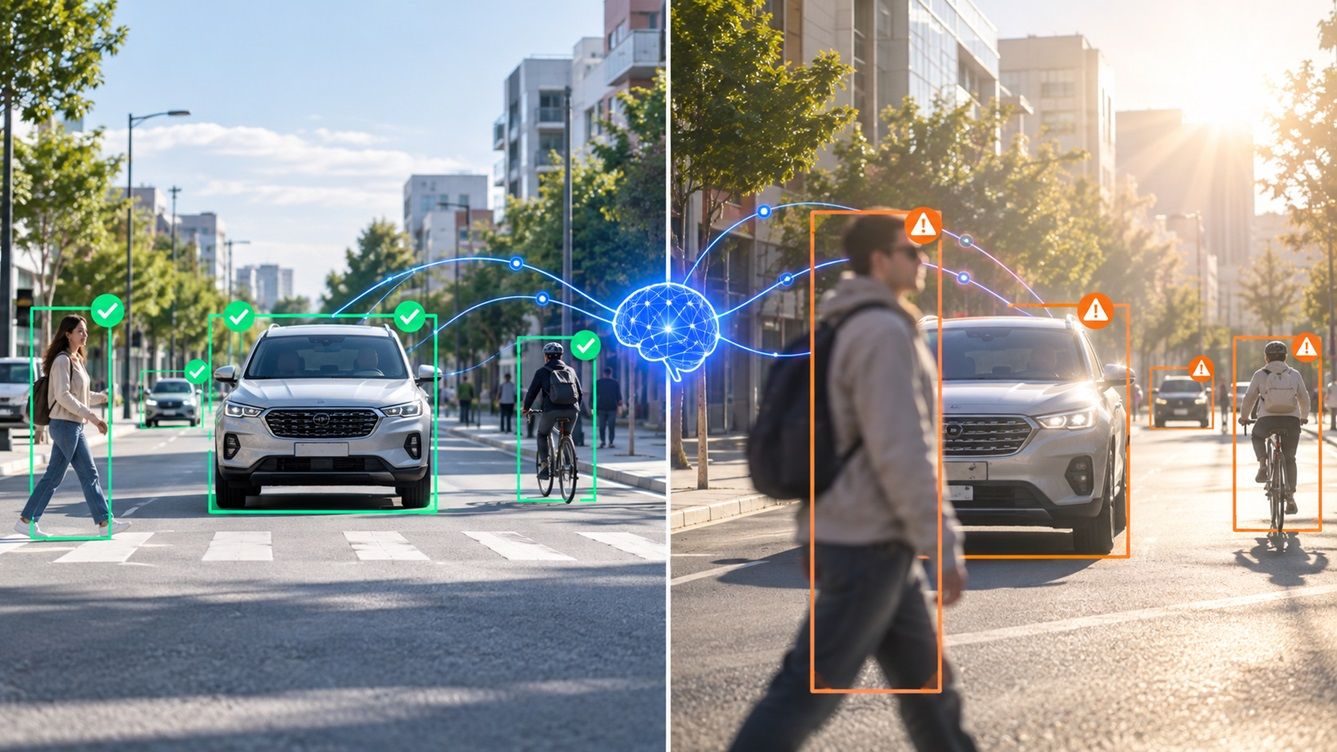
Именно здесь возникает главная зона конфликтов — так называемый Data Drift (дрейф данных).
Представим систему видеоаналитики на зоне отгрузки. При сдаче проекта точность детекции паллет составляла 99%. Спустя три месяца она упала до 82%. Заказчик открывает тикет на устранение «бага». Разбор инцидента показывает:
На складе заменили лампы освещения на более энергоэффективные (изменилась цветовая температура пикселей).
Служба эксплуатации сместила угол наклона камеры на 5 градусов во время уборки.
Поставщик начал использовать стрейч-пленку с другой степенью отражения.
Код нейросети не сломался. Алгоритм продолжает честно выполнять матричные умножения. Изменилась физическая реальность, для которой этот алгоритм создавался. Дрейф данных не классифицируется как гарантийный случай — это естественный процесс деградации модели, требующий запуска процедур MLOps.
Поддержка после релиза: почему систему нельзя «сдать и забыть»
Понимание того, что любая ML-модель начинает устаревать в ту же секунду, когда выходит в production, меняет подход к пост-проектному обслуживанию. Поддержка ИИ-продукта всегда идет по двум параллельным трекам.
Трек 1. Базовый IT-Support (Удержание инфраструктуры)
Это рутинная, но критически важная работа системных администраторов и DevOps-инженеров. Она включает мониторинг температуры и износа аппаратных компонентов (особенно если инференс идет на Edge-устройствах в сложных климатических условиях цеха), обновление драйверов NVIDIA, патчинг уязвимостей в базовых образах ОС и контроль переполнения хранилищ логов. Это фундамент, без которого система рухнет чисто физически.
Трек 2. MLOps и Continuous Training (Удержание точности)
Это зона ответственности Data Science команды и ML-инженеров. Процесс строится на системах управления жизненным циклом машинного обучения (подобных ClearML или MLflow).
Как выглядит ML-поддержка на практике:
- Мониторинг аномалий (Drift Detection): система в фоновом режиме отслеживает уверенность модели (Confidence Score). Если средний показатель уверенности при распознавании объектов начинает падать, или бизнес-метрики (например, количество пустых ячеек в WMS) расходятся с данными трекинга, в дашборде инженеров загорается алерт.
- Сбор краевых случаев (Edge Cases): кадры или логи, на которых модель отработала с низкой уверенностью, автоматически сохраняются в отдельный пул (карантин).
- Разметка и валидация: накопленные краевые случаи (новые типы униформы сотрудников, новые форм-факторы упаковки, засветы от солнца в летний период) отправляются на ручную разметку.
- Пайплайн дообучения (Retraining): размеченные данные добавляются в исходный датасет. Запускается автоматический пайплайн дообучения модели.
- Теневое развертывание (Shadow Deployment): новая версия весов (V2) не заменяет старую сразу. Она устанавливается параллельно и обрабатывает реальный поток данных, но её результаты не влияют на бизнес-процессы (не уходят в ERP/WMS). Инженеры сравнивают метрики V1 и V2 на живом потоке.
- Бесшовный релиз: если V2 стабильно показывает превосходство на новых данных и не деградировала на старых (отсутствие катастрофического забывания), трафик плавно переключается на новую архитектуру.
Выводы: экономика владения ML-системой
Внедрение машинного обучения — это переход от разовых капитальных затраты на лицензии к сложносоставному OPEX (операционные затраты на удержание системы в актуальном состоянии).
Если перед бизнесом стоит изолированная, не меняющаяся во времени задача (например, OCR-распознавание стандартных паспортов) — достаточно привлечь классического ИТ-интегратора для подключения готового API.
Но если цель — автоматизировать живой, динамичный процесс: промышленный конвейер, складскую логистику, перемещение техники или контроль качества с сотнями регулярно обновляющихся SKU — проекту необходим партнер с компетенциями полного цикла.
Такой подрядчик должен не только разработать архитектуру и встроить её в корпоративный контур, но и выстроить прозрачный процесс непрерывного сбора данных, мониторинга метрик и MLOps-поддержки, который защитит инвестиции бизнеса от неизбежного дрейфа физической реальности.
Мы в NeuroCore разрабатываем, интегрируем и сопровождаем ИИ-решения для B2B и B2G. Если нужна автоматизация процессов с помощью ИИ или других технологий, но вы не знаете, как подойти к залаче — начните с бесплатной консультации: