Секундная запись, в которой всего одно английское слово. Разметчик прослушивает его несколько раз, а выбрать правильную подпись не может: to, too и two звучат одинаково. Без контекста определить написание — задача сразу с несколькими "звездочками". Если специалист выберет вариант наугад, в датасете появится метка, которая может быть недостоверной.
С такими ситуациями сталкиваются при подготовке аудио для машинного обучения. Даже короткий фрагмент требует решений: что именно слышно, где заканчивается слово, кому принадлежит реплика и можно ли использовать запись для поставленной задачи. На примерах из практики направления разметки NeuroCore разберём, как устроена эта работа и какое значение она имеет для прикладных AI-систем.
Что такое разметка аудио и какие задачи она решает
Разметка аудио — это добавление к звуковым записям описаний, временных границ и категорий по согласованным правилам.
Полученные данные используют для обучения, дообучения и проверки моделей распознавания речи, разделения говорящих и классификации звуковых событий.
Состав разметки зависит от назначения системы:
- Голосовому помощнику нужны примеры команд
- Сервису субтитров — речь, переведённая в текст и привязанная ко времени
- Аналитике обслуживания — реплики участников и сведения, позволяющие разобрать взаимодействие.
- При транскрибации специалист фиксирует произнесённые слова. В инструкции определяют, сохранять ли повторы, оговорки, незавершённые фразы и слова-паразиты. Например, запись "ну, я… я хотел уточнить" можно представить дословно или отредактировать для чтения. Для обучающего набора выбор должен быть единым и соответствовать задаче.
- Временная разметка указывает начало и конец слова, реплики или события.
- Диаризация отвечает на вопрос, какой говорящий произносит речь на каждом участке записи. При классификации фрагменту назначают категорию: например, речь, музыка или сигнал оборудования. Проверка качества, отбор и обработка записей дополняют разметку на этапе подготовки датасета.
Короткое слово иногда сложнее длинного разговора
В одном из проектов нашей команды требовалось распределять по категориям файлы длительностью около секунды. Каждый содержал отдельное английское слово. Объём информации небольшой, но именно отсутствие контекста делало часть записей неоднозначной.
Пример с to, too и two показывает предел такой задачи. Различия в написании и значении восстанавливаются из контекста, которого в изолированной записи нет. Повторное прослушивание не добавляет недостающую информацию.
Если запись допускает несколько трактовок, разбираем её последовательно:
- Проверяем контекст. Прослушиваем фразу целиком, захватываем соседние реплики. Если получили только короткую нарезку, запрашиваем исходную запись.
- Сверяемся с инструкцией. Проверяем, как в проекте размечают такой случай. Если правила нет, передаём фрагмент на разбор ответственному специалисту. Принятое решение добавляем в инструкцию вместе с примером.
- Фиксируем результат. Если контекст прояснил запись, присваиваем подтверждённую метку. Если однозначного ответа нет, отмечаем неопределённость. В выборку, требующую точного написания слова, такой фрагмент не включаем.
При приёмке проверяем, чем подтверждена метка: самой записью, доступным контекстом и правилами проекта. Неразрешённые случаи остаются явно отмеченными — догадку нельзя принимать за достоверную разметку.
Щелчок или часть слова?
В одном из проектов мы отбирали записи без щелчков и других нежелательных звуков. На коротких фрагментах возникали разногласия: один специалист слышал помеху, другой — часть произнесённого слова. Если удалить такой звук ошибочно, вместе с ним потеряется часть речи.
Поэтому спорный фрагмент разбираем в несколько шагов.
1. Слушаем звук внутри слова и фразы
Короткий щелчок отдельно от речи легко принять за дефект. Прослушиваем участок с захватом соседних звуков, затем слово и фразу целиком. Проверяем, где возникает помеха: в паузе, поверх речи или на границе слова.
Если после нескольких прослушиваний трактовки расходятся, передаём запись на дополнительную проверку.
2. Определяем, что мешает использовать запись
У разных проблем разные последствия:
- Одиночный щелчок — проверяем, затрагивает ли он речь и удаётся ли убрать его без повреждения слова.
- Фоновый гул, музыка, работа оборудования — оцениваем разборчивость речи и соответствие будущим условиям работы системы.
- Перегрузка микрофона — проверяем, насколько искажены слова. Снижение громкости уже записанного файла не восстанавливает потерянные детали.
- Обрыв записи — отмечаем, какая часть слова или реплики отсутствует.
- Посторонний разговор — определяем, относится ли он к задаче и удаётся ли отделить его от нужного диалога.
Эти случаи закрепляем в инструкции на конкретных примерах. Разметчик получает образцы допустимых записей, брака и фрагментов для повторной проверки.
3. Сохраняем фон, характерный для рабочей среды
Если модель будет распознавать разговоры возле кассы, в данных нужны записи с такой акустикой: холодильником, кофемашиной, музыкой и голосами из зала. Полностью очищенная студийная речь не отражает этих условий.
При отборе проверяем две вещи: соответствует ли запись сценарию проекта и достаточно ли в ней информации для достоверной разметки. Если шум заглушил ответ клиента, этот участок отмечаем как неразборчивый. Содержание ответа по контексту не дописываем.
4. Сравниваем результат обработки с исходником
После очистки повторно слушаем обработанный участок и соседние слова. Проверяем, сохранились ли согласные, окончания и короткие тихие реплики, не появились ли новые искажения.
Результат принимаем по сохранности речи и пригодности для задачи. Более тихий фон сам по себе не подтверждает качество обработки. Если вместе с помехой исчезла часть слова, такой результат возвращаем на доработку.
Для исключённых записей фиксируем причину: обрыв, искажение, неразборчивая речь или другой согласованный дефект. По этим отметкам заказчик видит, какие материалы потеряны и что исправить при следующем сборе данных.
А если несколько человек говорят одновременно?
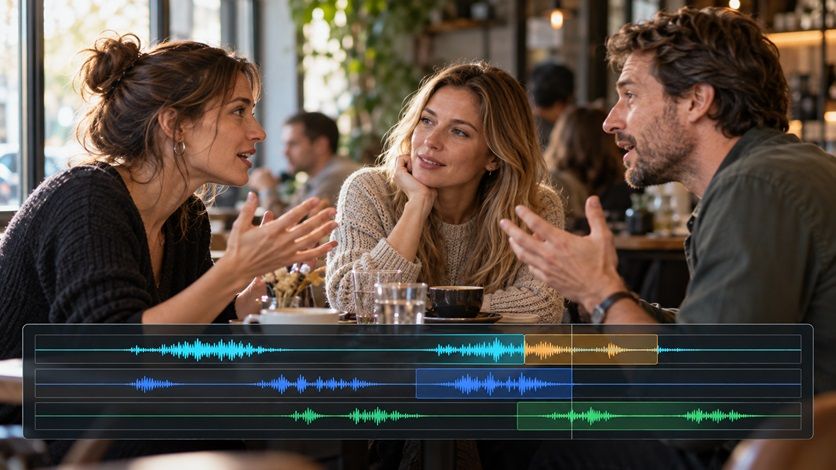
Сотрудник ещё задаёт вопрос, а клиент уже отвечает. Рядом разговаривает другой посетитель, и на его фоне звучит короткое "да". При разметке такого диалога разбираем, кто говорит, какие слова удаётся различить и где реплики накладываются друг на друга.
1. Прослушиваем разговор целиком
Сначала знакомимся с голосами и ходом разговора. Если начать с короткого вырезанного фрагмента, легко перепутать участников или потерять связь между вопросом и ответом.
2. Закрепляем обозначение за каждым голосом
Присваиваем участникам идентификаторы: говорящий 1, говорящий 2 и далее. На протяжении записи сохраняем их за теми же голосами. Сомнительную принадлежность реплики отмечаем для повторной проверки.
3. Размечаем время каждого участника отдельно
Фиксируем начало и конец реплик. Когда люди говорят одновременно, сохраняем пересекающиеся интервалы: речь одного участника не обрываем в момент, когда вступает другой. Так в разметке остаются оба голоса.
4. Записываем только то, что удалось расслышать
Понятную часть фразы расшифровываем, неразборчивый участок обозначаем принятой в проекте меткой. Например, если слышно "я хотел…", а продолжение заглушил другой голос, сохраняем начало и отмечаем пропуск. Окончание по смыслу не дописываем.
5. Устанавливаем роли по доступному контексту
После разделения голосов определяем, кто из участников сотрудник, клиент или курьер. Проверяем содержание разговора, каналы записи, а при наличии видео — происходящее в кадре. Если данных недостаточно, сохраняем обозначение говорящего без назначения роли.
При приёмке повторно слушаем участки с пересечением речи. Проверяем, что различимые реплики сохранены, голоса не перепутаны, а временные границы соответствуют записи. Все неразборчивые слова и спорные назначения остаются явно отмеченными.
Как команда добивается единообразной разметки
Несовпадение трактовок одного фрагмента показывает, где правила требуют уточнения. До обработки большого массива полезно провести пробную разметку небольшой выборки, включающей типичные и сложные записи. Это позволяет обнаружить расхождения, пока их исправление не требует пересмотра всего датасета.
Работу стоит организовать в несколько этапов:
- Определить назначение датасета. Какая модель будет использовать данные и какое решение должен поддерживать её результат?
- Описать состав меток. Нужны ли слова, временные границы, говорящие, роли, звуковые события и признаки качества?
- Согласовать инструкцию. Зафиксировать правила записи чисел, сокращений, пауз, пересечений речи и неразборчивых участков.
- Проверить понимание правил на общей выборке. Разобрать расхождения и добавить в инструкцию показательные примеры.
- Контролировать результат в ходе работы. Проверять сложные случаи, техническую корректность файлов и соблюдение принятой схемы.
Для большой команды важна фиксация изменений инструкции. Если правило пересмотрели, необходимо определить, какие уже обработанные записи затронуты. Иначе внутри датасета останутся разные подходы к одной категории, хотя формально все файлы будут размечены.
Автоматическая расшифровка может ускорить подготовку предварительного текста. Затем его проверяют по записи в соответствии с требованиями проекта. Особенно внимательно стоит относиться к тихим ответам, коротким словам, именам и профессиональной лексике: правдоподобная фраза ещё не подтверждает, что именно она была произнесена.
Приёмка готового аудиодатасета
При приёмке проверяем состав поставки, техническую корректность файлов и качество разметки. Основание для оценки — согласованная инструкция: набор категорий, обязательные поля, точность временных границ и правила обработки спорных записей.
1. Комплектность и соответствие заданию
Сверяем количество и длительность записей, состав категорий и распределение материала по согласованным условиям. Проверяем наличие исходного аудио, файлов разметки, метаданных и актуальной версии инструкции. Исключённые записи сопровождаются причиной исключения.
2. Техническая корректность
Автоматически проверяем весь набор:
- аудиофайлы доступны, открываются и соответствуют заданному формату;
- каждая разметка связана с нужной записью;
- временные отметки находятся в пределах файла, начало интервала предшествует его окончанию;
- категории и структура данных соответствуют согласованной схеме;
- обязательные поля заполнены, идентификаторы корректны;
- отсутствуют непредусмотренные дубликаты.
Пересечения интервалов оцениваем по правилам проекта: при одновременной речи нескольких участников они допустимы.
3. Точность расшифровки
Сопоставляем текст с аудио: выявляем пропуски, замены и добавленные слова. Проверяем запись чисел, сокращений, профессиональных терминов, повторов и незавершённых фраз. Неразборчивые участки обозначаются установленными метками; восстановленные по догадке слова считаются ошибкой.
4. Временные границы и принадлежность речи
Проверяем начало и конец размеченных слов, реплик и событий в пределах согласованной погрешности. Отдельно оцениваем короткие ответы, паузы и участки одновременной речи.
Идентификаторы говорящих сохраняются за одними и теми же голосами на протяжении записи. Прикладные роли — сотрудник, клиент, курьер — проверяем по доступному контексту. Спорная принадлежность остаётся отмеченной.
5. Единообразие разметки и качество сложных записей
Проверяем, одинаково ли специалисты применяют правила к сходным случаям. В контрольную выборку включаем тихую речь, сильный фон, пересечения голосов, короткие ответы и неоднозначные фрагменты.
Результаты фиксируем отдельно по каждой группе. Общая доля ошибок не показывает, например, что команда систематически пропускает тихие ответы клиента. Объём ручной проверки и допустимый уровень ошибок согласовываем до приёмки.
6. Разделение обучающей и контрольной выборок
Проверяем отсутствие общих записей, дубликатов и фрагментов одного исходного аудио в обучающей и контрольной частях. Если задача предусматривает проверку на новых говорящих или объектах, разделяем данные и по этим признакам.
Такое разделение защищает последующую оценку модели от утечки данных и позволяет проверить её на материале, который не использовался при обучении.
Результат приёмки — протокол качества. В нём фиксируем объём проверенных данных, ошибки по категориям и условиям записи, соответствие критериям и решение по поставке. Для доработки указываем конкретные файлы, интервалы и нарушенные пункты инструкции. После исправлений повторно проверяем затронутые данные; при систематической ошибке расширяем проверку на соответствующую часть датасета.
От разметки аудио к контролю обслуживания — как работает наш продукт Лоялика AI
Лоялика AI — продукт NeuroCore для аудита качества обслуживания по видео и аудио. Система выделяет отдельные взаимодействия сотрудника с клиентом и проверяет их по чек-листу: приветствие, предложение дополнительного товара, бонусной программы, прощание и другие согласованные пункты.
Для такой проверки требуется восстановить содержание разговора, определить участников и связать их реплики с конкретным эпизодом обслуживания. Ошибки в подготовке данных отражаются на обучении модели и достоверности последующей оценки.
Разберём на примере разговора у кассы
Сотрудник спрашивает: "Кофе в дорогу?" Клиент тихо отвечает: "Нет". Рядом работает кофемашина, из зала доносятся голоса других покупателей.
В этом эпизоде сотрудник предложил дополнительный товар, а клиент отказался. Это два самостоятельных факта. Для проверки допродажи фиксируем предложение сотрудника. Для анализа реакции покупателя — его ответ. Отказ клиента сам по себе не означает нарушения со стороны сотрудника.
При подготовке данных сохраняем обе реплики, их принадлежность и временные границы. Каждая ошибка меняет содержание примера, на котором обучается или проверяется система:
| Ошибка в разметке | Что искажается |
| Пропущено тихое "нет" | В эталонном диалоге отсутствует ответ клиента; проверить его распознавание по такому эталону невозможно |
| Перепутаны говорящие | Ответ клиента приписан сотруднику или предложение сотрудника — покупателю |
| Неверно указаны временные границы | Реплика обрезана либо к ней присоединены слова из соседнего разговора |
| Неразборчивый участок заполнен по догадке | В эталоне появляется фраза, которую запись не подтверждает |
| Отсутствие различимой речи отмечено как нарушение | Ограничение записи превращается в ошибочную оценку обслуживания |
Поэтому состав разметки определяем через пункты чек-листа: какой факт проверяем и какие данные его подтверждают.
Как Лоялика AI собирает эпизод обслуживания
Работа системы объединяет несколько этапов.
- Выделение сессии по видео. Видеомодуль помогает определить участников, их роли и время нахождения в зоне обслуживания. Это задаёт границы эпизода, к которому затем привязывается разговор.
- Обработка аудио и распознавание речи. Из записи выделяются речевые фрагменты, формируется расшифровка. Короткие тихие ответы требуют отдельного внимания: если детектор пропустил реплику, она не попадёт на распознавание.
- Сопоставление видео и аудио. Реплики связываются с сессией по времени с учётом возможного рассогласования записей. Так фраза из соседнего разговора не становится основанием для оценки другого клиента.
- Проверка по чек-листу. Система ищет признаки выполнения согласованных пунктов в пределах собранной сессии.
- Подготовка материалов для проверки. Результат сопровождается кадрами, аудиофрагментом и транскрипцией. Ответственный сотрудник получает возможность проверить основание автоматического решения.
Зачем нужны записи с реальных объектов
Акустика торговой точки отличается от студийной речи. Сотрудник находится ближе к микрофону, клиент отвечает тише, оборудование создаёт постоянный фон. Односложный ответ легко потерять ещё на этапе выделения речи.
В Лоялика AI предусмотрены дополнительная обработка аудио и дообучение распознавания на размеченных диалогах с объектов. Такие данные отражают реальные условия: короткие ответы, названия товаров, числа, профессиональную лексику и характерные помехи.
Разметка здесь выполняет две задачи: даёт материал для адаптации моделей и формирует эталон для независимой проверки результата. Контрольные сессии отделяются от обучающих данных.
Подготовим аудиоданные под задачу вашего бизнеса
Мы в NeuroCore начинаем с обозначения и описания задачи: расшифровывать обращения, распознавать команды или проверять обслуживание по чек-листу. Анализируем записи из реальной рабочей среды, с характерными голосами, оборудованием и фоновыми звуками.
На пробной выборке проверяем пригодность материала, разбираем спорные фрагменты и определяем состав разметки. До обработки основного массива фиксируем инструкцию, критерии качества и порядок приёмки. Объём датасета рассчитываем с учётом разнообразия сценариев и условий записи.
Готовим данные для машинного обучения и разрабатывает AI-системы для бизнеса. Оставьте заявку на консультацию: разберём ваши записи, определим требования к датасету и предложим этапы работы с проверяемым результатом: