Сценарий, знакомый любому руководителю направления машинного обучения или техническому директору в зрелой компании: специалист по машинному обучению берёт выделенный сервер с парой мощных графических ускорителей, пишет несколько сот строк кода в Jupyter Notebook, обучает модель, получает красивые графики сходимости и объявляет: "Все готово, модель даёт 92% точности, забирайте в промышленную эксплуатацию!".
А дальше тупик.
Бэкенд-разработчики не понимают, как отдать полученный файл весов в микросервисную архитектуру. Инженеры инфраструктуры не понимают, почему Docker-контейнер с PyTorch весит 15 ГБ и забирает всю память GPU. Модель кое-как выкатывают в продакшн через самописный скрипт на FastAPI, а через пару месяцев точность предсказаний тихо деградирует до уровня случайного угадывания, потому что входные данные в реальном мире изменились, а про систему все забыли.
Чтобы машинное обучение не превращалось в хаотичное кладбище скриптов, потерянных весов и сгоревших впустую GPU-часов, и существует подход MLOps (Machine Learning Operations).
В этой статье разберем, как устроен MLOps изнутри, с какими инфраструктурными проблемами сталкиваются даже крупнейшие компании, как правильно организовать виртуализацию GPU и почему попытка собрать MLOps-платформу своими силами часто обходится дороже, чем её аренда.
Что такое MLOps и чем он отличается от классического DevOps
MLOps — это не просто "DevOps для нейросетей". Это инженерная культура, набор инструментов и регламентов, объединяющих разработку ML-моделей, инженерию данных и промышленную эксплуатацию (DevOps/SRE).
Принципиальная разница между традиционным ПО и ML-системой кроется в природе самого продукта:
- Классический софт детерминирован. Его поведение задано кодом. Если вы написали функцию, покрыли её модульными тестами (unit-тестами) и развернули контейнер, алгоритм будет одинаково работать и сегодня, и через год.
- ML-система вероятностна. Она состоит из трех равнозначных компонентов: Код + Данные + Аппаратные ресурсы.
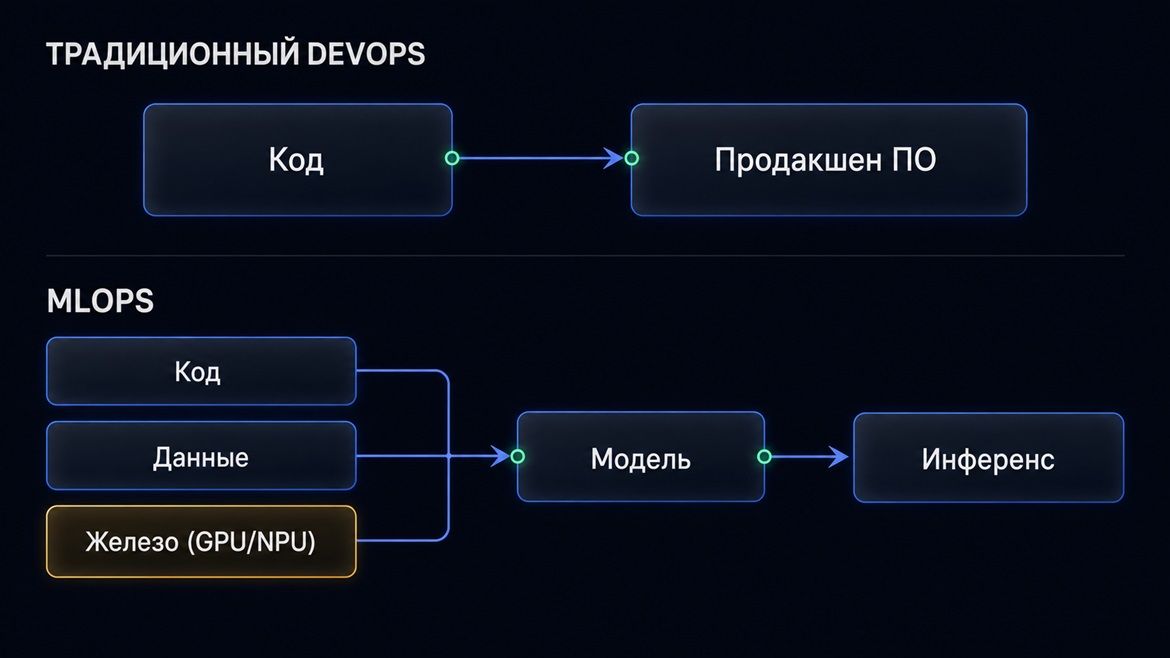
Если в реальном мире меняются входящие данные (Data Drift или Concept Drift), качество работы модели падает, даже если исходный код не менялся ни на строчку. MLOps обеспечивает непрерывный цикл: от подготовки данных и параллельного обучения на кластерах до мониторинга инференса и автоматического дообучения (retraining).
Когда компании критически необходим MLOps: 4 главных симптома
Если у вас в штате работает один специалист по данным, который решает одну изолированную задачу, полноценная MLOps-платформа вам, скорее всего, не нужна. Но как только команда разрастается до 3–5 человек, а количество моделей в промышленной эксплуатации превышает десяток, система начинает рассыпаться под собственной сложностью.
Вот четыре базовых симптома, указывающих на то, что процессы пора менять:
- Проблема "голодания" и неэффективного использования GPU
В компании есть несколько команд или специалистов. Команда А забирает себе 4 карты NVIDIA A100/H100 под длительный эксперимент. При этом реальная утилизация вычислительных ядер GPU колеблется в районе 15–20%: инженер пишет код, смотрит на графики или ушел на обед, но монопольно удерживает карту. В это же время Команда Б ждет в очереди неделю, чтобы прогнать короткую валидацию. Без централизованного пула вычислительных ресурсов (GPU Lake), динамических MIG-профилей (Multi-Instance GPU) и прозрачного учета стоимости GPU-часов бизнес просто сжигает миллионные бюджеты на железо.
- Хаос с версионированием датасетов и артефактов
"Где лежит чекпоинт модели, которая выдала лучший F1-score в прошлом месяце?" — "Кажется, на локальном NVMe у Васи, а Вася уволился". Если датасеты хранятся в разрозненных сетевых папках, а веса моделей распиханы по личным директориям инженеров, повторить результаты эксперимента становится невозможно. Компания теряет главную ценность — наработанную интеллектуальную собственность.
- Ручной инференс и медленный вывод в продакшн
Вывод новой версии модели на сервер занимает недели. Каждая команда изобретает собственный веб-сервер на FastAPI или Flask, вручную конвертирует веса в TensorRT/ONNX и самостоятельно решает проблемы с очередями запросов, вместо того чтобы использовать стандартизированные сервисы вывода (например, ClearML Serving, Triton Inference Server или vLLM).
- Отсутствие мониторинга и невидимые сбои
Когда обучающая задача в Kubernetes падает по нехватке памяти (OOM) или из-за ошибки CUDA-драйвера, инженер тратит полдня на поиск логов в разрозненных системах. В продакшне никто не отслеживает время отклика (latency), пропускную способность (throughput) и просадку метрик качества на реальном трафике.
Как это устроено у гигантов: реалии
Изучение опыта крупных корпораций показывает, что построить идеальную MLOps-инфраструктуру удается единицам. На рынке доминируют решения на базе OpenSource, но почти везде главная проблема — отсутствие централизации:
- Крупные телеком-операторы часто разворачивают отдельные изолированные инстансы MLFlow под каждую команду. В результате теряется глобальный контроль утилизации GPU, а подсистемы дублируют друг друга.
- ИТ-гиганты и экосистемы фокусируются на специфичных внутренних фреймворках. Их архитектура заточена под узкие задачи контура, а порог входа для новых инженеров оказывается слишком высоким.
- Крупный финтех исторически опирается на тяжелые Hadoop/Spark-кластеры. Это удобно для классической аналитики табличных данных, но неповоротливо при современной работе с LLM, аудио и компьютерным зрением.
- Облачные провайдеры пытаются запускать собственные MLOps-платформы, но их решения часто остаются сырыми, а интеграция с локальной инфраструктурой заказчика (On-Premises) превращается в сложный квест.
Главная проблема рынка — попытка собрать MLOps из десятка разрозненных OpenSource-инструментов без единого окна управления (Single Pane of Glass).
Архитектура зрелой MLOps-платформы: взгляд изнутри
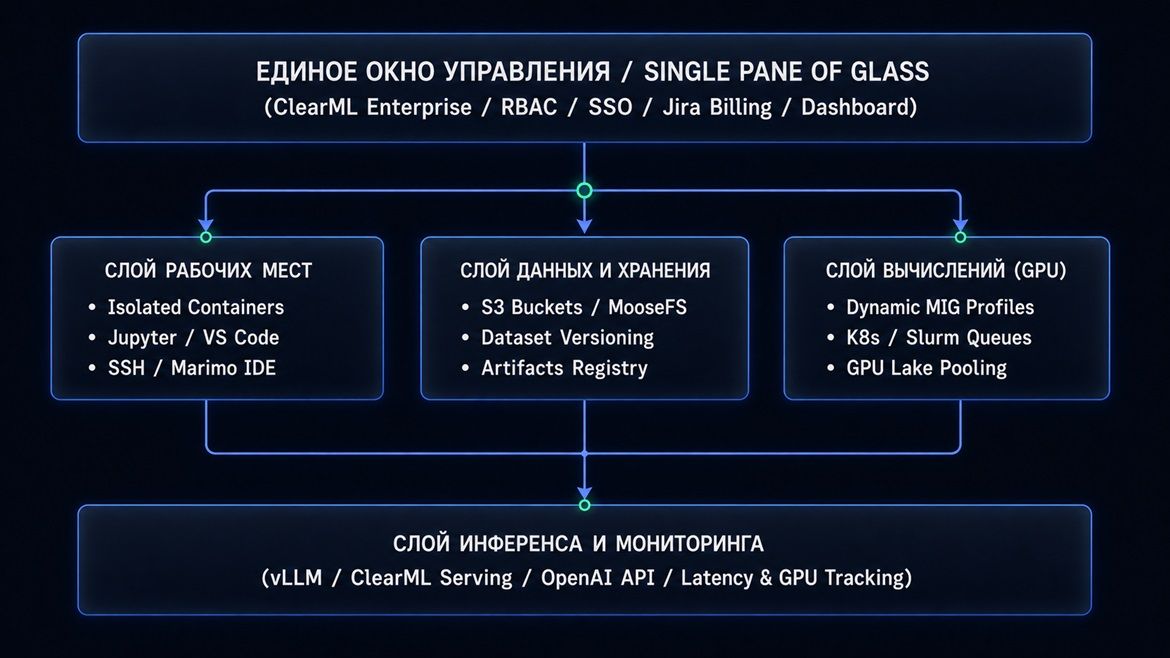
Грамотно спроектированная MLOps-платформа соединяет в единый контур разработку, данные и вычисления. Рассмотрим, из каких инженерных слоев состоит такая система.
1. Слой вычислений и виртуализация GPU (GPU Lake)
Вместо того чтобы закреплять физические карты за отдельными сотрудниками, все графические ускорители объединяются в единый пул (GPU Lake). Задействуется технология NVIDIA MIG (Multi-Instance GPU): одна физическая карта уровня H100 или A100 динамически разделяется на изолированные аппаратные профили (например, 1g.10gb или 2g.20gb).
На небольших MIG-профилях инженеры отлаживают код, обработку данных и прогоняют легкие тесты.
Для тяжелого дообучения (Fine-Tuning) LLM или тренировки крупных моделей компьютерного зрения система автоматически выделяет честные монопольные вычислительные узлы с несколькими GPU.
Управление очередями задач происходит через связку Kubernetes и Slurm с гибкой приоритезацией: критичные продакшн-задачи выполняются мгновенно, а фоновые эксперименты встают в очередь.
2. Изолированные рабочие места (Dev Workspaces)
Инженер не должен тратить время на настройку окружения, драйверов и зависимостей. Из единого интерфейса за секунды поднимается изолированный Docker-контейнер с нужным инструментарием:
- SSH-доступ для работы из локальной среды разработки (IDE);
- веб-версии VS Code или Jupyter Lab;
- современные интерактивные среды (Marimo) с поддержкой LLM-генерации кода.
При остановке сессии состояние рабочей директории и профиль сохраняются в хранилище, а выделенные ресурсы GPU моментально возвращаются в общий пул.
3. Слой хранения и версионирования (Data & Artifacts Layer)
Использование распределенных файловых систем (например, MooseFS) и объектных S3-хранилищ исключает дублирование массивных датасетов. Каждый запуск задачи автоматически фиксирует:
- точный Git-хеш кода;
- версию обучающей выборки;
- конфигурацию гиперпараметров и системные метрики (загрузка GPU, температура, расход VRAM);
- итоговые веса модели и логи.
4. Реестр моделей и серверы вывода (Model Registry & Serving)
Все успешные эксперименты попадают в единый реестр моделей с четкой ролевой моделью разграничения прав (RBAC). Для запуска инференса используются специализированные бекенды:
- vLLM для высокопроизводительной работы с языковыми моделями и поддержкой OpenAI-совместимого API;
- ClearML Serving для быстрого оборачивания моделей компьютерного зрения и классических ML-алгоритмов в производственные REST/gRPC-эндпоинты.
Своя разработка vs MLOps-as-a-Service?
Когда руководство компании осознает необходимость перехода на MLOps, возникает классический выбор: построить систему внутри или привлечь специализированную команду?
Попытка собрать MLOps-платформу своими силами часто выглядит привлекательно на бумаге, но разбивается о реальные затраты: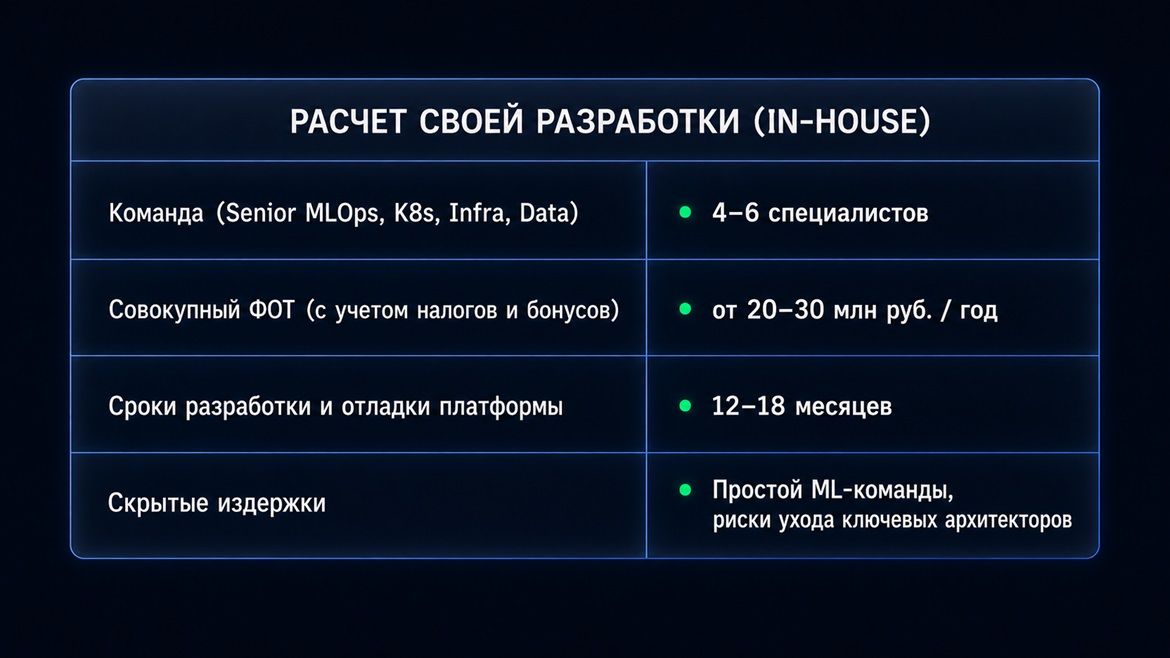
Пока ваша инженерия занимается настройкой CSI-драйверов, интеграцией Slurm, написанием систем биллинга под Jira и развертыванием Helm-чартов, специалисты по машинному обучению продолжают писать код на локальных машинах и "жгут" дорогие ресурсы.
Подход NeuroCore: MLOps как сервис
Мы в NeuroCore не просто консультируем — мы внедряем, дорабатываем и берем на полное инфраструктурное сопровождение готовую, проверенную в боях MLOps-платформу.
В основе нашего подхода лежит глубокая экспертиза настройки ClearML (как Community, так и Enterprise версий), интегрированного с отказоустойчивой инфраструктурой вычислений и хранения:
- Оптимизация расходов на железо: разворачиваем централизованный пул GPU с поддержкой динамических MIG-профилей и очередей задач. Это поднимает среднюю утилизацию карт с типичных 20–25% до 45–80%, экономя миллионы рублей на закупке новых серверов.
- Единая точка входа и контроль безопасности: интегрируем ролевую модель (RBAC), Active Directory / SSO, изоляцию S3-бакетов по командам и детальный биллинг GPU-часов с привязкой к задачам в Jira.
- Автоматизация CI/CD и инференса: настраиваем автоматическое развертывание через Ansible, Helm и GitLab CI/CD, внедряем высоконагруженный инференс на базе vLLM и ClearML Serving с поддержкой OpenAI API.
- Профессиональная поддержка 24/7: команда наших инженеров берет на себя весь низкоуровневый MLOps — от мониторинга состояния железа и отслеживания длинных очередей до бесшовного обновления компонентов платформы без простоя продакшна.
В результате ваша команда машинного обучения получает удобное, стандартизированное рабочее место и сосредоточена исключительно на гипотезах и бизнесе, а руководство — прозрачный учет расходов, высокую скорость вывода моделей на рынок и гарантированную сохранность данных.
Если вы хотите прекратить хаос в ML-разработке, оптимизировать утилизацию видеокарт и запустить прозрачный MLOps-контур без многомиллионных трат на построение платформы с нуля —напишите нам: