Создание биометрической базы на 10000 лошадей
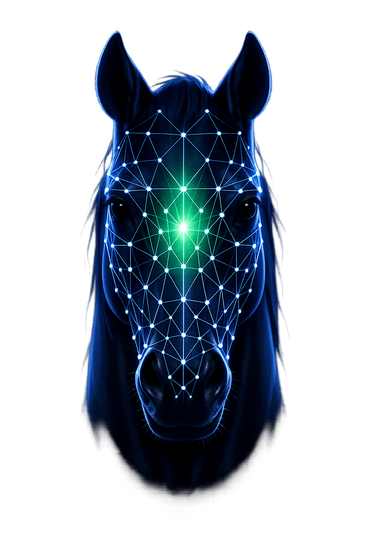
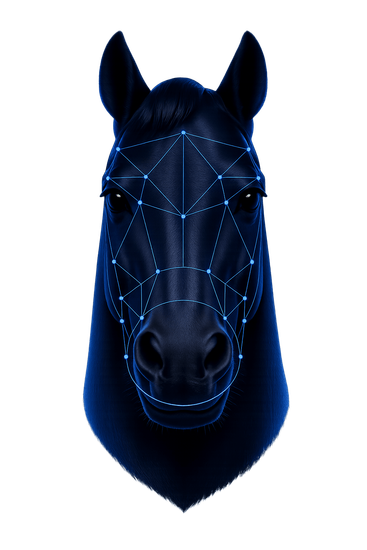
Система автоматического сбора и отбора изображений лошадей по биометрическим признакам позволила сформировать датасет для ИИ-идентификации 10 000 особей за две недели вместо нескольких месяцев.
NDA
ЗаказчикКрупный агропромышленный холдинг, занимающийся племенным разведением лошадей.
ЗадачаСформировать уникальный датасет для обучения нейросети, способной идентифицировать каждую особь.
Бизнес-цель: предотвратить смешивание табунов, сохранить здоровую иерархию и чистоту породы, что напрямую влияет на стабильность и рентабельность животноводческого бизнеса.
Техническое требование: собрать по 10 качественных фотографий для 10 000 уникальных лошадей, где четко видны ключевые биометрические точки морды.
О проекте
Для племенного животноводства точная идентификация животных — это основа управляемости бизнеса: от контроля поголовья до сохранения породных характеристик и снижения операционных рисков. Ошибки в учёте и перемещении животных напрямую приводят к стрессу, сбоям в процессах и финансовым потерям.
Заказчику требовалась система, способная различать каждую лошадь и отслеживать её перемещения между табунами. Без этого невозможно поддерживать стабильную структуру поголовья и контролировать последствия смешения животных.
Ключевым ограничением стал не алгоритм, а данные: для обучения системы идентификации требовался большой и при этом качественный массив изображений, которого не существовало в готовом виде. Поэтому фокус проекта сместился на создание эталонного датасета с нуля — как фундамента для всей будущей ИИ-системы и её устойчивой работы.
NDA
ЗаказчикКрупный агропромышленный холдинг, занимающийся племенным разведением лошадей.
ЗадачаСформировать уникальный датасет для обучения нейросети, способной идентифицировать каждую особь.
Бизнес-цель: предотвратить смешивание табунов, сохранить здоровую иерархию и чистоту породы, что напрямую влияет на стабильность и рентабельность животноводческого бизнеса.
Техническое требование: собрать по 10 качественных фотографий для 10 000 уникальных лошадей, где четко видны ключевые биометрические точки морды.
х10 раз быстрее
1
Стратегия сбора данных
Определили источники, языки и географии для обеспечения разнообразия и репрезентативности данных.2
Пилот и выявление ограничений
Проверили стандартные методы сбора и зафиксировали их немасштабируемость из-за качества и дубликатов данных.3
Нейросеть-фильтр качества
Обучили модель, автоматически отбирающую изображения, соответствующие биометрическим требованиям.4
Сквозная автоматизация процесса
Реализовали пайплайн через Telegram-бота для потоковой обработки и структурирования данных.5
Валидация и передача датасета
Провели финальную проверку и передали готовый датасет для обучения модели идентификации.Интересные факты
Технологический стек
Backend
Логика обработки и базовые компоненты системы
ML
Модели и фреймворки для обучения
Вызовы и решения
Низкая эффективность ручного сбора
Первые 2 месяца работы показали, что традиционный подход (парсеры + ручной отбор) не позволяет выполнить проект в срок. Мы получали массу "мусорных" данных, а скорость пополнения базы уникальными лошадьми была критически низкой.РЕШЕНИЕ
Применить AI для сбора данных для AI
Вместо того чтобы пытаться улучшить старый метод, мы автоматизировали самую трудоемкую часть — проверку качества. Разработка собственной нейросети-фильтра, которая взяла на себя 99% рутинной работы по отбраковке, стала переломным моментом. Это позволило нам не просто ускорить процесс, а выйти на совершенно новый уровень эффективности и масштабируемости.Дубликаты и "заезженные" данные
Интернет переполнен одними и теми же фотографиями популярных пород и знаменитых лошадей. Наши парсеры постоянно приносили одни и те же изображения с разными фильтрами или в разном разрешении, создавая иллюзию разнообразия.РЕШЕНИЕ
Интеллектуальная система на базе Telegram-бота
Связка из Telegram-бота и нейросети-фильтра позволила нам быстро обрабатывать огромные объемы данных из не самых очевидных источников (тематические Telegram-каналы). Система не просто отсеивала неподходящие кадры, но и помогала в кластеризации похожих изображений, что значительно упростило поиск дубликатов и обеспечило реальную уникальность данных в итоговом датасете.за 13 дней
собрали все фото
70 000+
качественных изображений
95%
точность автоматической фильтрации данных
Команда, которая внедрила проект
Марк Яговкин
Руководитель разметки данных
Роман Фёдоров
Бизнес-аналитик
Бесплатный разбор вашей задачи
На экспертной встрече разберем, какие сценарии внедрения ИИ для вашего бизнеса перспективны и возможны на вашем действующем оборудовании. Подготовим экономическое обоснование внедрения ИИ.
Рассмотрим технические ограничения и возможный первый этап проекта.
Готовые проекты
Наша команда с 2017 года успешно реализовала 60 проектов с искусственным интеллектом. Тут собраны наши лучшие работы, про которые мы можем рассказать, про некоторые совсем немного, а некоторые мы вообще не можем тут упомянуть из-за NDA. Но готовы применять опыт в разработке нейросетей для ваших задач.
Разработка ИИ-системы
ИИ-видеоконтроль упаковки и отгрузки товаров для маркетплейсов
Разработка крупной системы
Нейросеть для определения возраста: аналитика и безопасность в одном решении
ИИ для образования
Распознавание рукописного текста на экзаменационных бланках с помощью нейросети

Разработка крупной системы
ИИ-система для оценки повреждений автомобилей

Пилотный запуск
Интеллектуальная видеоаналитика для контроля периметра, выявления угроз на интроскопах и БПЛА
Видеоаналитика для ресторанов
ИИ-контроль времени сборки заказов